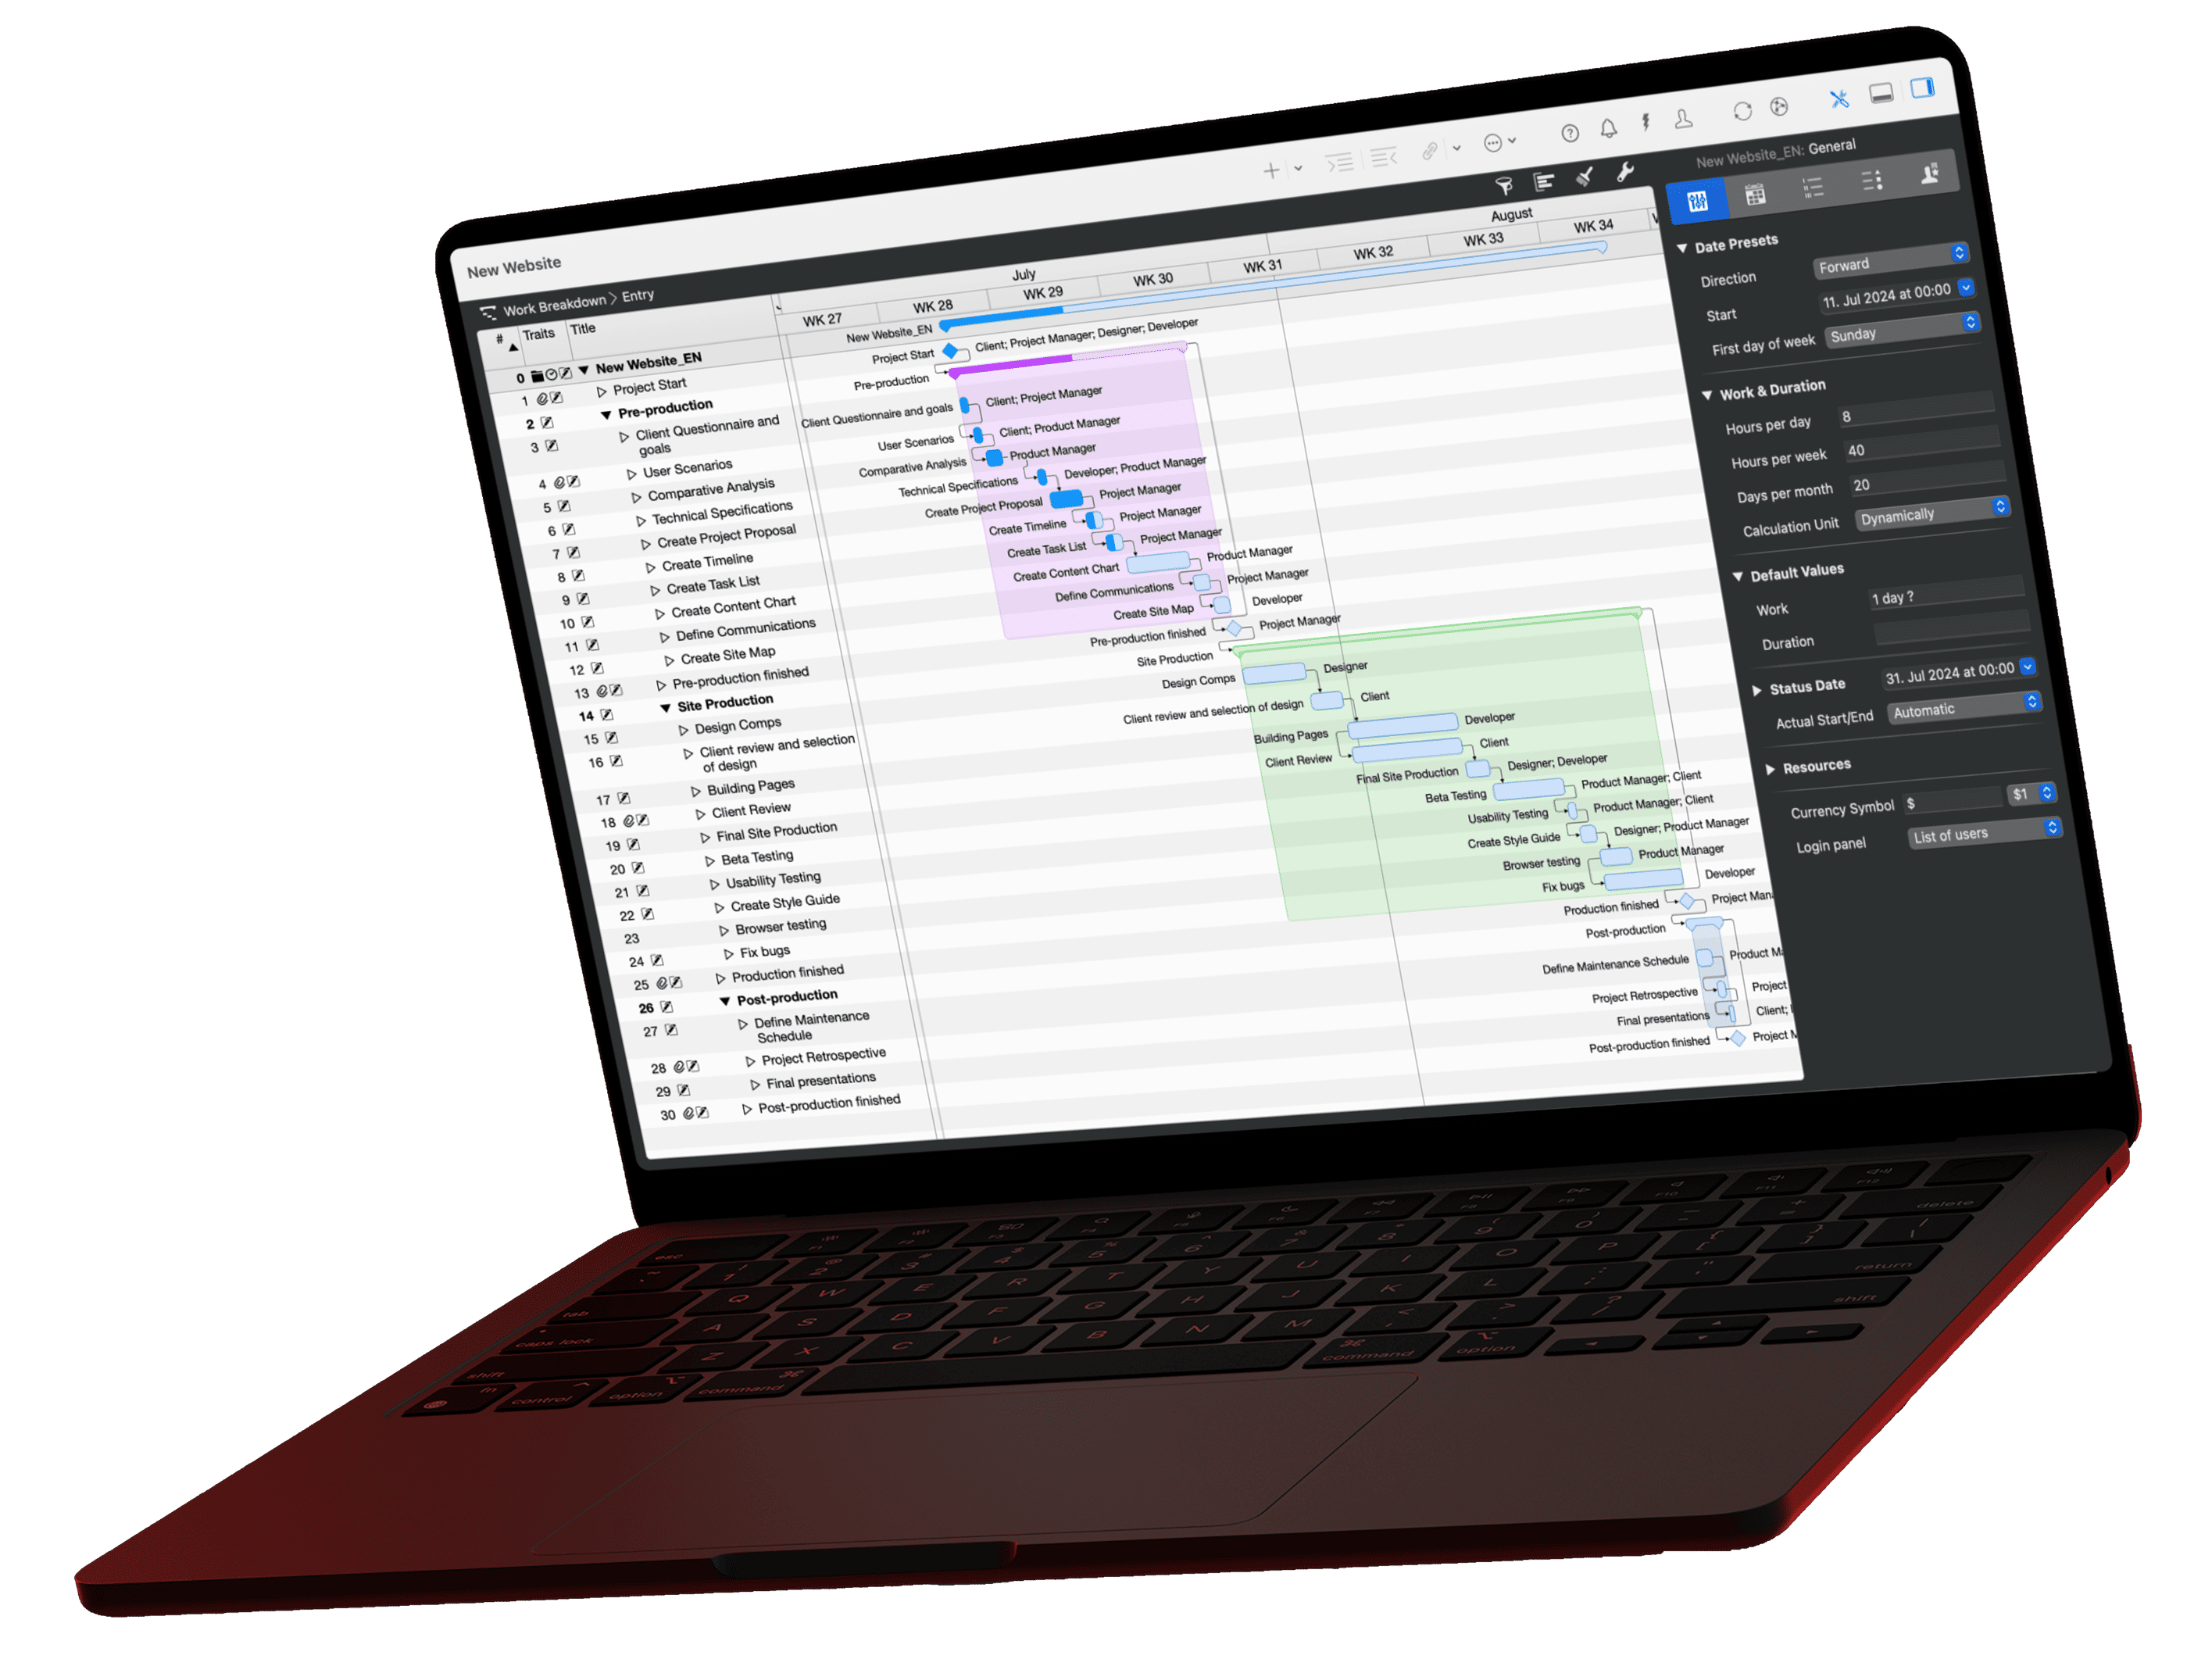
KANO 模型根据产品特性对客户满意度的影响,将其分为五类:必备型、期望型(一维型)、魅力型、无差异型和反向型需求。狩野纪昭(Noriaki Kano)与三位合作者于 1984 年在日本品质管理学会会刊上发表了该模型。每个特性用一组两道题的问卷来确定类别。
KANO 模型图
三类主要需求的满意度(纵轴)与具备程度(横轴)
什么是 KANO 模型?
KANO 模型是一种质量管理工具,根据某项需求具备或缺失时满意度的变化程度来区分需求。它的核心观点是:满意与不满意并不对称。一个功能缺失会引起不满,但它的存在未必让人满意。
狩野纪昭、濑乐信彦、高桥文夫和辻新一在论文《魅力的品質と当り前品質》(Attractive Quality and Must-be Quality)中提出该模型(《品質》第 14 卷第 2 期,1984 年 4 月,第 147 至 156 页,DOI 10.20684/quality.14.2_147)。如今,产品团队和项目经理用它来决定哪些需求纳入范围、哪些可以推迟。在时间、成本和范围构成的三重约束中,KANO 模型从客户角度为范围提供依据。它补充了把质量视为符合规格的传统观点。
KANO 模型的五类需求是什么?
KANO 模型区分五类需求,每一类描述具备程度与满意度之间的不同关系。字母代码来自英文原始文献。示例是一款面向工地负责人的工地 App,下文的计算示例也使用它。
| 类别 | 代码 | 具备时 | 不具备时 | 示例:工地 App |
|---|---|---|---|---|
| 必备型 (Must-be) | M | 理所当然,满意度不提升 | 强烈不满 | 无信号区域的离线模式 |
| 期望型 (One-dimensional) | O | 满意度随具备程度上升 | 不满随缺失程度增加 | 在图纸上定位照片 |
| 魅力型 (Attractive) | A | 满意度大幅提升 | 不会不满,没人期待 | 语音记录缺陷 |
| 无差异型 (Indifferent) | I | 无影响 | 无影响 | 深色模式 |
| 反向型 (Reverse) | R | 不满 | 满意 | 自动向业主发送周报 |
第六种回答类别不是需求类别:Q(Questionable,可疑结果)表示回答自相矛盾,例如功能具备和缺失时都回答“喜欢”。这类回答说明问题表述有误。
KANO 问卷如何设计?
KANO 问卷为每个特性设置一组问题:正向问题(“如果 App 能做 X,您感觉如何?”)和反向问题(“如果 App 不能做 X,您感觉如何?”)。受访者用同一个五级量表回答这两道题。
回答选项和评价表来自 Charles Berger、David Walden 等人编写的文集《Kano’s Methods for Understanding Customer-defined Quality》(Center for Quality of Management Journal,第 2 卷第 4 期,1993 年秋,PDF):
- 喜欢
- 理应如此
- 无所谓
- 能忍受
- 不喜欢
以离线模式为例:正向问题是“App 在没有网络时也能使用,您感觉如何?”,反向问题是“App 在没有网络时无法使用,您感觉如何?”。请从使用角度而不是技术角度表述两道题,并询问真正会使用该功能的干系人。
KANO 评价表
评价表把每组回答转换为唯一一个类别。行是正向问题的回答,列是反向问题的回答。
| 正向 ↓ · 反向 → | 喜欢 | 理应如此 | 无所谓 | 能忍受 | 不喜欢 |
|---|---|---|---|---|---|
| 喜欢 | Q | A | A | A | O |
| 理应如此 | R | I | I | I | M |
| 无所谓 | R | I | I | I | M |
| 能忍受 | R | I | I | I | M |
| 不喜欢 | R | R | R | R | Q |
如果一位工地负责人对离线模式的正向问题回答“理应如此”,对反向问题回答“不喜欢”,结果是 M,即必备型需求。“喜欢”加“无所谓”得到 A,即魅力型需求。
如何分析 KANO 问卷?五个功能的示例
分析 KANO 问卷时,统计每个特性中各类别出现的次数,并把该特性归入出现最多的类别。Berger 等人把这一规则称为众数。若次数相同,按 M、O、A、I 的顺序取舍,因为排在前面的类别对产品影响更大。
示例:一款工地 App 的产品团队在规划下一版本,向 40 位工地负责人询问了五个功能。下表是套用评价表后的回答分布。
| 功能 | A | O | M | I | R | Q | 类别(占比) | Better | Worse |
|---|---|---|---|---|---|---|---|---|---|
| 离线模式 | 3 | 9 | 22 | 5 | 0 | 1 | 必备型 (55.0%) | 0.31 | −0.79 |
| 在图纸上定位照片 | 9 | 18 | 8 | 5 | 0 | 0 | 期望型 (45.0%) | 0.68 | −0.65 |
| 语音记录缺陷 | 19 | 7 | 2 | 11 | 1 | 0 | 魅力型 (47.5%) | 0.67 | −0.23 |
| 深色模式 | 7 | 3 | 2 | 24 | 3 | 1 | 无差异型 (60.0%) | 0.28 | −0.14 |
| 自动向业主发送周报 | 6 | 2 | 1 | 12 | 17 | 2 | 反向型 (42.5%) | 0.38 | −0.14 |
Better 和 Worse 两列来自 Mike Timko,他在同一文集中介绍了这两个系数。它们只计算 A、O、M 和 I:
- Better = (A + O) / (A + O + M + I):提供该功能时满意度提升多少?
- Worse = −(O + M) / (A + O + M + I):缺少该功能时满意度下降多少?
离线模式的 Better = (3 + 9) / 39 = 0.31,Worse = −(9 + 22) / 39 = −0.79。在五个功能中,缺少离线模式的损害最大,而具备它几乎不会带来惊喜。图纸定位照片在两个方向上的数值都高(0.68 和 −0.65),是典型的期望型需求。语音输入令人满意(0.67),缺少它几乎不影响满意度(−0.23)。
请注意接近的结果:图纸定位照片有 18 个 O,同时有 9 个 A 和 8 个 M。Berger 等人建议在这种情况下同时查看第二多的类别,或按用户群分别分析。
如何用 KANO 模型确定优先级?
使用 KANO 模型时,按必备型、期望型、魅力型的顺序确定优先级。无差异型推迟,反向型删除或作为可关闭的选项提供。示例中的结论是:
- 首先保证离线模式。没有它,无论版本里还有什么,都会流失用户。
- 其次改进图纸定位照片。每一次改进都直接提升满意度。
- 在 1 和 2 完成后,把语音输入作为魅力型需求纳入计划。
- 推迟深色模式。
- 自动周报不作为默认设置。
KANO 模型不涉及工作量。语音输入需要两周还是两个季度,只有基于工作量的方法才能体现,例如用覆盖面、影响和信心除以工作量的 RICE 评分。若要快速区分必须做和可以做的需求,可以使用 MoSCoW 方法。KANO 模型为二者提供来自客户的依据。
如何在 Merlin Project 中管理 KANO 类别?
在 Merlin Project 中,为每个活动添加一个自定义字段来记录 KANO 类别,再按该字段对项目计划进行聚合和筛选。版本中的每个功能都成为计划中的一个活动,并清楚显示其类别。
- 创建字段: 选取 插入 > 列,选择 对于新字段,在 字段名称 中输入“KANO 类别”,然后点按 插入列 确认。在该列的检测器中把 类型 设为 文本。
- 设定数值: 在 预定义值 中输入五个类别:必备型、期望型、魅力型、无差异型、反向型。保持 允许自由条目 关闭,避免出现不同写法。
- 分配类别: 选中一个或多个活动,在检测器的 用户定义 标签页中,于 字段 下的 值 列选择类别。该值适用于所有选中的活动。
- 按类别聚合: 在聚合中点按 + 创建自己的聚合,在 群组 下的 依 后面选择字段“KANO 类别”。选择 于每个可能值 时,尚无活动的类别也会显示。
- 隐藏反向型需求: 创建自己的筛选条件,逻辑选 否,条件设为“KANO 类别 等于 反向型”。计划中只显示真正要实现的范围。
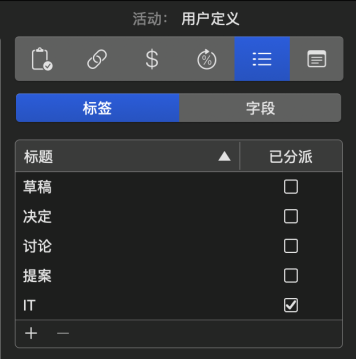
检测器中的自定义字段
在 用户定义 标签页中,检测器在 字段 下列出活动的所有自定义字段及其值。截图显示的是字段“优先级”及其值“高”;“KANO 类别”字段会出现在同一位置。自定义字段、筛选条件和聚合属于 Merlin Project 的功能,Merlin Project Express 中没有。
资源紧张时的可选做法: Merlin Project 为每个活动提供 0 到 1000 的 优先 值,位于检测器 计划 标签页的 高级 部分。它只在资源调配时生效:Merlin Project 先安排优先级较高的活动,并延迟优先级较低的活动。把 KANO 顺序映射到预设级别,资源调配时就会先推迟魅力型需求,而不是必备型需求:

- 必备型:1,000(非常高)
- 期望型:750(高)
- 魅力型:500(正常)
- 无差异型:250(低)
- 反向型:不纳入计划
结论
KANO 模型能区分客户视为理所当然的需求和真正提升满意度的需求。每个特性一组问题加上评价表即可完成分类;Better 和 Worse 显示特性在两个方向上的影响强度。在项目计划中,把类别记录为自定义字段,就能看到每个活动为何属于项目范围。
本文是优先级方法三部曲的最后一篇,前两篇分别介绍 MoSCoW 方法 和 RICE 评分法。如有问题,请给我们发送电子邮件。
如果您对这篇博客文章有任何疑问或希望参与讨论,欢迎您在我们的论坛中发帖。
常见问题
KANO 模型是谁提出的?
当时任职于东京理科大学的狩野纪昭与濑乐信彦、高桥文夫和辻新一共同提出了该模型。他们于 1984 年 4 月在日本品质管理学会会刊《品質》上发表了论文《魅力的品質と当り前品質》。
必备型需求和期望型需求有什么区别?
必备型需求被视为理所当然:缺失时客户不满,具备时满意度也不会提高。期望型需求按比例起作用:满足得越好,客户越满意。在问卷中,区别体现在正向问题的回答上:“理应如此”得到 M,“喜欢”得到 O。
KANO 模型在项目管理中怎么用?
在项目管理中,KANO 模型为项目范围提供依据。必备型需求必须纳入,期望型需求随预算调整,魅力型需求最后安排,反向型需求删除。在 Merlin Project 中,可以把类别记录为每个活动的自定义字段。
KANO 问卷中的 Q 是什么意思?
Q 代表 Questionable,即自相矛盾的一组回答,例如两道题都回答“喜欢”。某个功能的 Q 很多,说明问题可能表述不清。请重新设计这组问题,而不是解读结果。
KANO 模型和 RICE 该用哪个?
两者回答不同的问题。KANO 模型说明功能如何影响满意度,需要做问卷。RICE 用覆盖面、影响和信心除以工作量,得出排序。先用 KANO 识别必备型需求,再用 RICE 为其余功能排序。